같은 용량의 D램 칩을 더 쌓으면 저장 용량은 늘어납니다. 대역폭과 AI 처리 속도는 데이터 통로와 작업 조건까지 함께 봐야 해요.
HBM 기사에서 8단, 12단, 16단이라는 표현을 자주 만납니다. 8단을 16단으로 바꾸면 두 배 높으니 두 배 빠를 것 같지만, 여기에는 서로 다른 숫자가 섞여 있어요. 몇 장을 쌓았는지, 얼마나 담을 수 있는지, 초당 얼마나 옮길 수 있는지를 하나씩 나눠 볼게요.
먼저 HBM이란? AI GPU에 왜 필요할까를 읽으면 용량과 대역폭의 차이를 잡는 데 도움이 됩니다. 이번 글은 HBM 스택 하나를 기준으로 시작하고, 마지막에 GPU 주변의 스택 개수를 구분합니다.
1. 8단·12단·16단은 무엇을 세는 숫자일까?
여기서 단수는 적층한 D램 메모리 다이의 수를 말해요. 8H·12H·16H의 H는 high를 뜻하며, 12단이라면 메모리 다이 12장을 쌓았다고 읽으면 됩니다. 아래에서 연결을 담당하는 베이스 다이는 메모리 다이 단수와 구분해 표시하겠습니다.
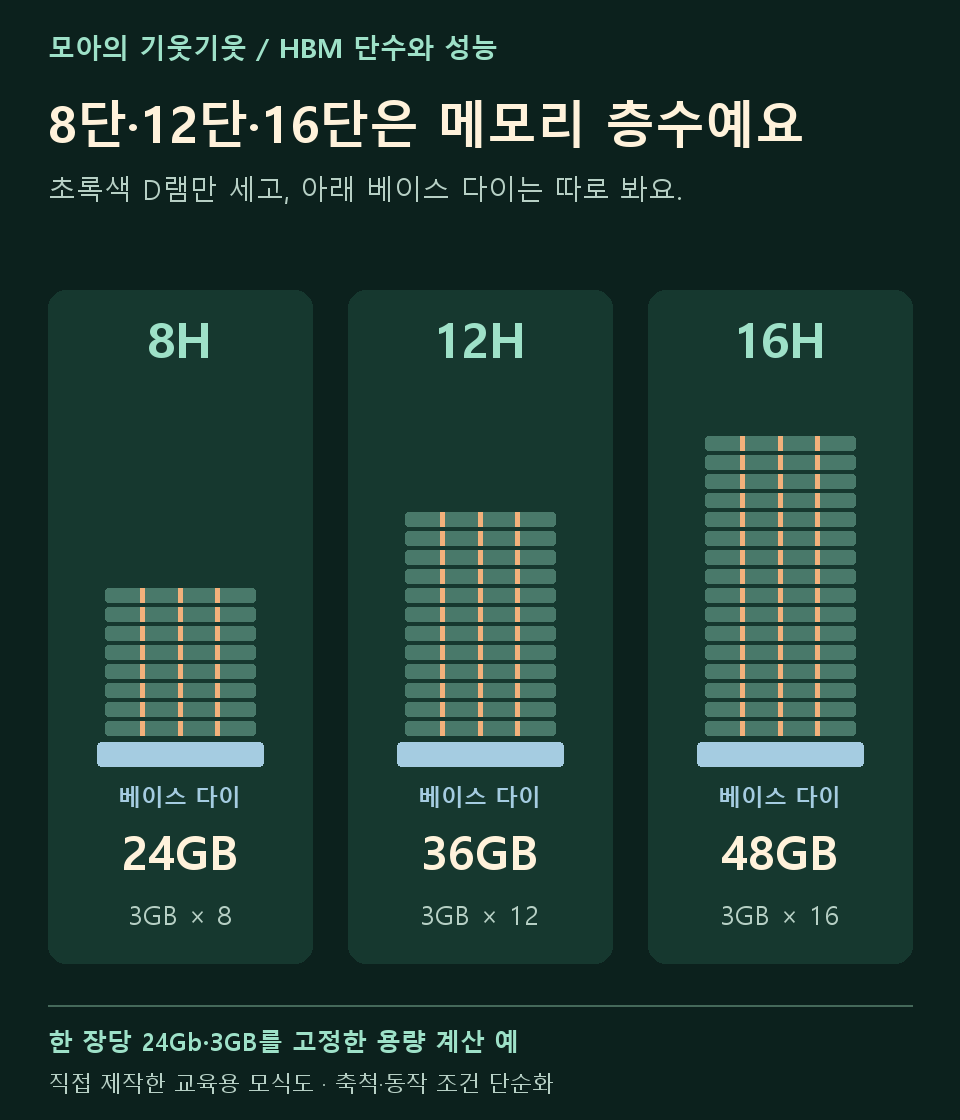
그림 1. 초록색 메모리 층만 세고 파란색 베이스 다이는 따로 봐요. 그림은 층수 설명용이며, 제품의 실제 높이가 단수에 비례한다는 뜻은 아닙니다. HBM의 적층과 베이스 다이 구조는 Micron의 HBM 설명과 SK하이닉스의 베이스 다이 설명을 참고했습니다.
HBM3E와 HBM4는 세대, 8단·12단·16단은 적층 수예요. 세대가 달라지면 입출력 데이터폭과 핀당 전송률, 회로와 패키징 조건도 달라질 수 있으므로 ‘16단’이라는 숫자만 보고 성능을 판단하기 어렵습니다.
2. 용량은 칩 한 장의 용량 × 장수
칩 한 장이 같은 크기의 창고 한 층이라고 생각해 보세요. 같은 창고를 더 올리면 보관할 수 있는 양이 늘어납니다.
스택 용량 = 메모리 다이 한 장의 용량 × 적층 단수
다이 한 장이 24Gb, 즉 3GB인 조건을 고정하면 다음처럼 계산할 수 있어요. Gb는 비트, GB는 바이트이며 8비트가 1바이트입니다.
• 8단: 3GB × 8 = 24GB
• 12단: 3GB × 12 = 36GB → 8단 대비 1.5배
• 16단: 3GB × 16 = 48GB → 8단 대비 2배
이 수열은 실제 제품 사례를 이해하는 데도 도움이 됩니다. SK하이닉스는 2024년 9월 26일 발표에서 3GB D램 8장의 24GB 제품과 12장의 36GB 제품을 설명했어요. 출처: 12단 HBM3E 양산 발표
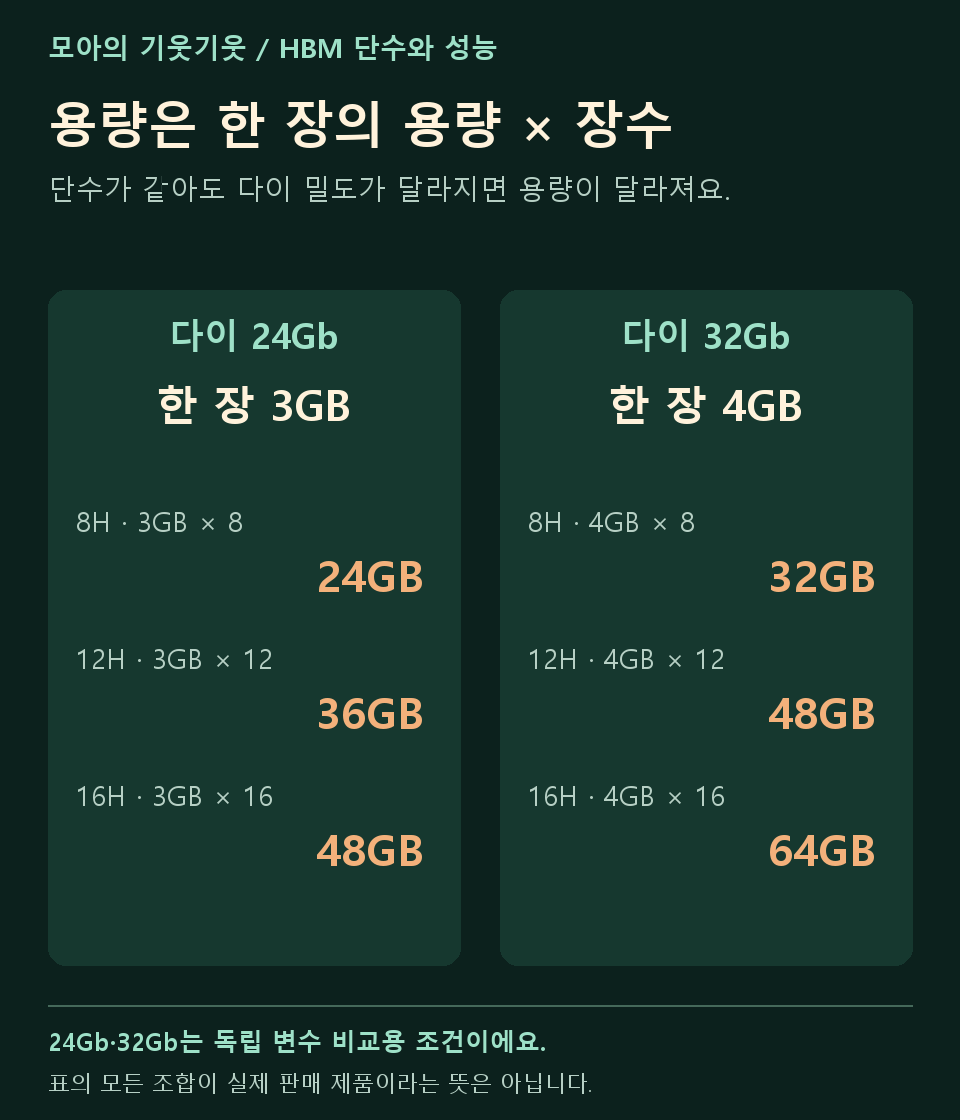
그림 2. 아래 행의 32Gb·4GB 다이는 칩당 용량을 바꿔 보는 계산 조건이에요. 모든 단수·밀도 조합이 실제 판매 제품이라는 뜻은 아닙니다.
단수가 같아도 칩당 용량이 다르면 스택 용량도 달라져요. 예를 들어 12단에 3GB 다이를 쓰면 36GB, 4GB 다이를 쓰면 48GB입니다. 따라서 ‘12단은 언제나 36GB’라고 외우기보다 단수와 다이 밀도를 함께 읽는 게 정확해요. 용량은 제조사의 GB 표기 관례를 따르고, 뒤의 대역폭 계산은 십진 GB/s를 사용합니다.
3. 대역폭 계산에는 왜 단수가 없을까?
대역폭은 스택 바깥으로 데이터를 옮기는 통로의 폭과 통로당 전송률로 계산합니다. 이번 비교에서는 스택의 외부 데이터폭 1,024bit, 핀당 전송률 9.2Gb/s를 고정해 볼게요.
이론적 최대 대역폭 = 데이터폭 × 핀당 전송률 ÷ 8
1,024 × 9.2 ÷ 8 = 1,177.6GB/s, 약 1.18TB/s
이 조건에서 8단을 12단·16단으로 바꿔도 외부 데이터 통로가 자동으로 늘어나지는 않아요. 따라서 계산 결과는 세 경우 모두 1,177.6GB/s입니다. 1,024bit에 단수를 다시 곱하면 외부 통로 수를 중복해 계산하게 됩니다. 입력값의 근거는 삼성 HBM 제품 설명의 HBM3E 항목에서 확인할 수 있어요.
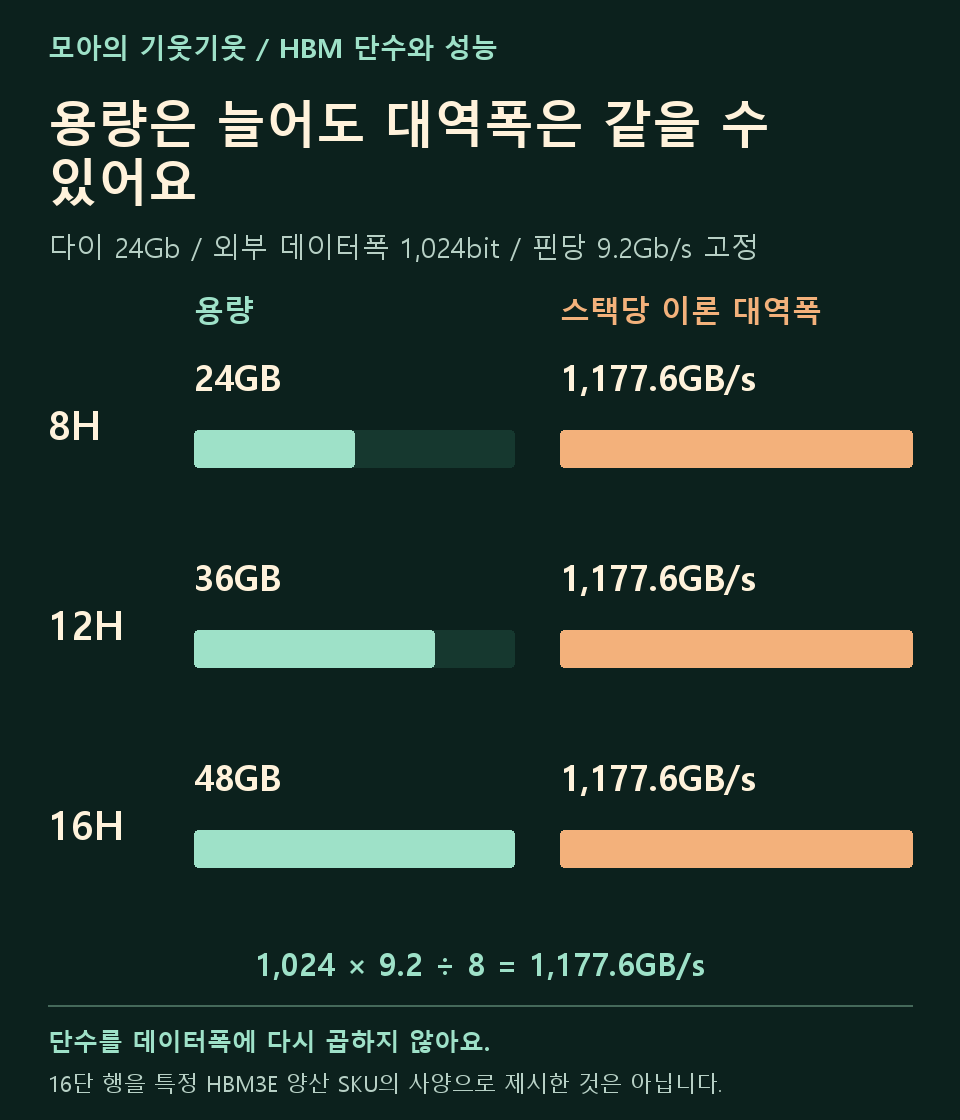
그림 3. 칩당 24Gb·데이터폭 1,024bit·핀당 9.2Gb/s를 고정한 학습용 비교입니다. 특히 16단 행을 특정 HBM3E 양산 제품의 사양으로 제시한 것은 아닙니다.
실제 제품에서도 이 구분을 볼 수 있어요. Micron은 HBM3E 8H·12H를 각각 24GB·36GB로 설명하면서, 두 제품군의 대역폭을 모두 스택당 1.2TB/s 초과로 소개합니다. 용량이 1.5배라고 대역폭 사양까지 1.5배가 되는 것은 아니라는 사례예요. 출처: Micron HBM3E FAQ
이론값이 같다고 모든 작업의 실효 대역폭과 지연시간까지 같다는 뜻은 아니에요. 실제 동작에는 접근 패턴, 메모리 컨트롤러, 명령·리프레시와 전력·온도 조건 등이 함께 작용합니다.
4. 실제 제품은 세대·단수·발표 상태를 함께 읽어요
현재 확인한 자료의 사례를 범위별로 나눠 보겠습니다. 아래의 날짜와 상태는 해당 발표 당시의 설명이며, 이를 2026년 11월의 모든 고객·제품에 대한 공급 상태로 확대하지 않습니다.
• HBM3E 8H·24GB / 12H·36GB: Micron 제품 페이지의 용량 사례. 제품 설명
• HBM4 16단·48GB: SK하이닉스의 CES 2026 전시 발표 사례. 2026년 1월 CES 발표
• HBM4 12H·36GB 양산 출하 / 16H·48GB 샘플 출하: Micron의 2026년 3월 16일 발표 사례. 두 상태를 구분해서 읽어야 해요. 발표 원문
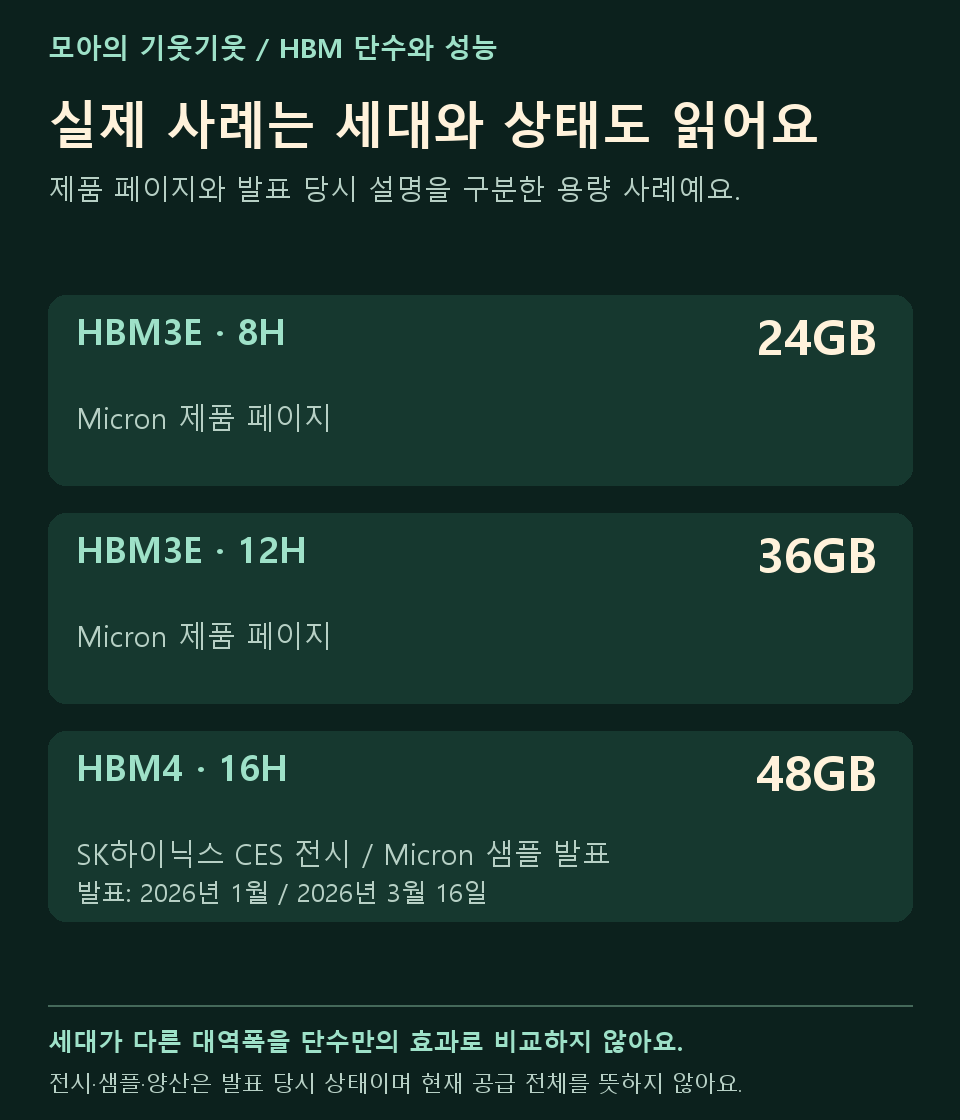
그림 4. 용량 사례를 읽는 그림이에요. 서로 다른 세대의 대역폭을 단수만의 효과로 비교하지 않습니다.
같은 12단인데 대역폭이 달라지는 사례도 있습니다. Micron은 2026년 3월 발표에서 HBM4 36GB·12H의 대역폭을 2.8TB/s 초과로 소개하고, 같은 용량·단수의 HBM3E 대비 2.3배라고 설명했어요. 이 수치는 제조사 공표 비교이며 AI 처리 속도가 2.3배라는 의미는 아닙니다. 출처 및 비교 조건: 발표 본문·주석 1
이때는 단수를 더한 효과와 세대가 바뀌며 인터페이스가 달라진 효과를 구분해야 해요. Micron은 HBM4에 2,048bit 인터페이스를 소개합니다. 핀당 전송률도 제품별로 함께 확인해야 합니다. 출처: Micron HBM4
5. 더 쌓는데 제품 높이는 같을 수도 있을까?
실제 적층에서는 칩을 얇게 만들고 접합·보호 구조를 관리합니다. 그래서 그림에서 16단을 8단의 두 배 높이로 그렸다고 실제 패키지 높이도 두 배가 되는 것은 아니에요.
SK하이닉스는 2024년 12단 HBM3E를 설명하면서, 앞선 8단 제품과 전체 두께를 유지하기 위해 각 D램 칩을 40% 얇게 만들었다고 밝혔습니다. 용량은 24GB에서 36GB로 50% 늘었어요. 출처: 2024년 9월 26일 제품 발표
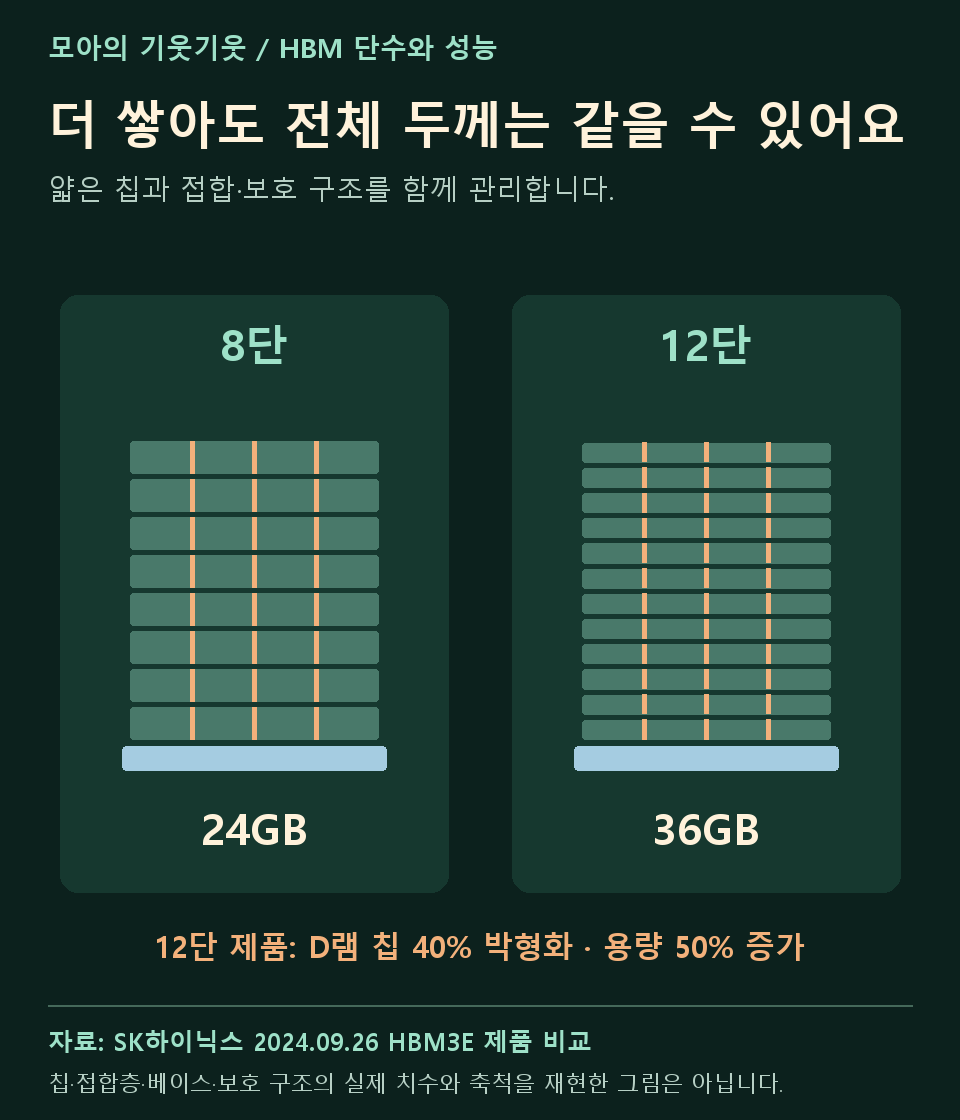
그림 5. 40%는 해당 제품과 이전 제품을 비교한 수치예요. 모든 HBM의 공통 박형화 조건은 아닙니다. 칩·접합층·베이스·보호 구조가 함께 높이를 구성하므로 전체 높이를 단수 하나로 계산할 수 없습니다.
얇은 칩을 다룰수록 지지와 손상·휨 관리가 중요하고, 접합과 검사·방열까지 함께 설계해야 합니다. 만드는 방법은 기존 연재의 웨이퍼 박형화, 마이크로범프 접합, 언더필·몰딩, 방열·최종 조립 편으로 이어 읽어 보세요.
6. ‘16단’과 ‘HBM 스택 16개’도 달라요
단수는 스택 안의 메모리 층수, 스택 개수는 GPU 주변 등에 배치한 HBM 덩어리 수입니다. 독립된 인터페이스를 가진 스택을 여러 개 병렬로 연결하면 GPU 전체의 용량과 합산 이론 대역폭이 함께 늘어날 수 있어요.
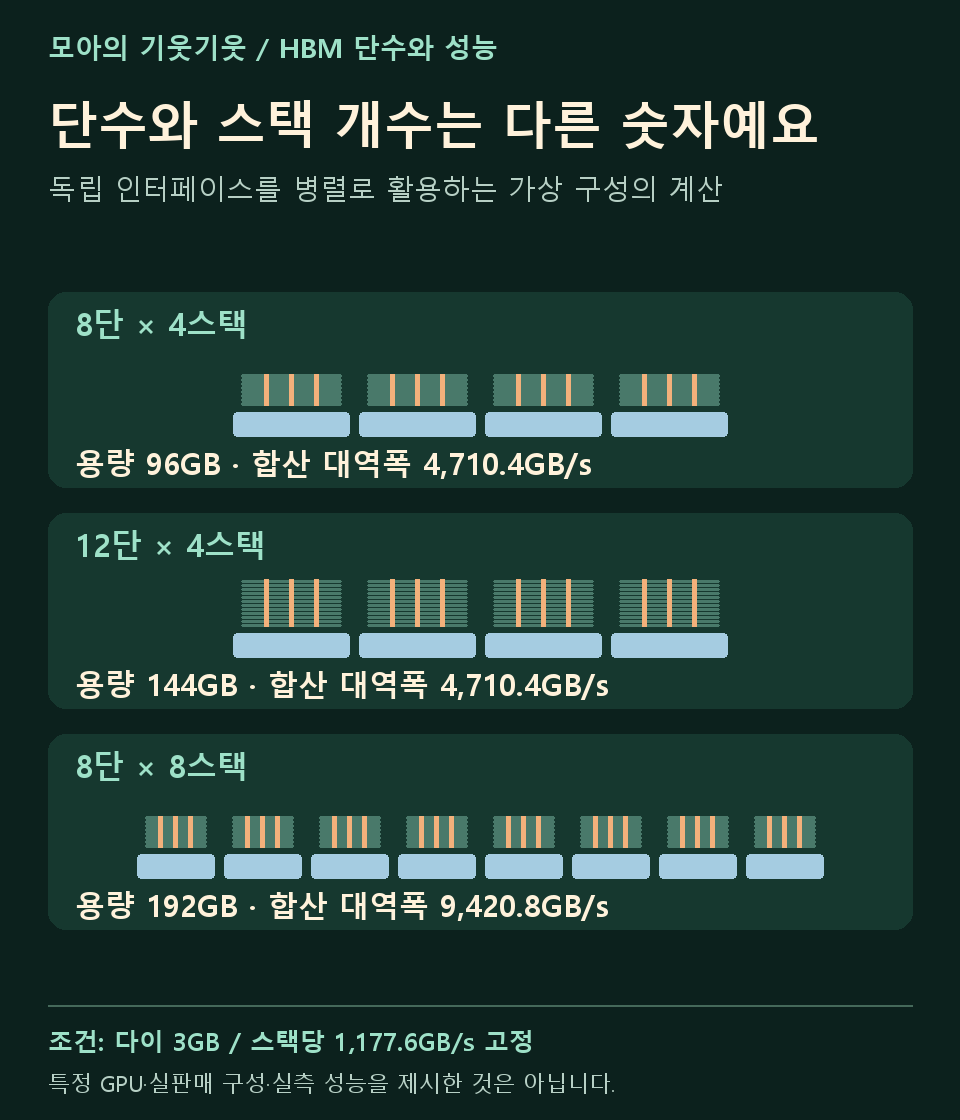
그림 6. 칩당 3GB·스택당 1,177.6GB/s를 고정한 가상 구성입니다. 각 스택의 통로를 병렬로 활용한다고 가정하며, 특정 GPU의 실측 성능이나 실판매 구성이 아닙니다.
예를 들어 8단·24GB 스택 4개라면 합계 96GB이고, 각 스택의 이론 대역폭을 더하면 4,710.4GB/s예요. 같은 4개를 12단·36GB로 바꾸면 용량은 144GB가 되지만, 스택당 데이터폭과 전송률이 그대로라면 합산 대역폭도 그대로입니다. 반면 같은 8단 스택을 8개로 늘리는 가상 구성은 용량 192GB, 합산 이론 대역폭 9,420.8GB/s로 계산됩니다.
7. 그렇다면 실제 AI 성능은 언제 좋아질까?
메모리에 담을 공간이 부족했던 작업이라면 용량 확대가 큰 도움이 될 수 있어요. 더 많은 데이터를 GPU 가까이에 유지할 여지가 생기기 때문입니다. 반면 이미 공간이 충분하고 데이터 공급량이 병목인 작업에서는 용량 증가만으로 그 병목이 풀리지는 않아요.
실제 속도는 계산 능력, 데이터 재사용, 병렬 처리와 메모리 접근 등에 따라 달라집니다. 그래서 이 글과 애니메이션은 단수별 AI 성능 배율이나 초당 토큰 수를 만들어 제시하지 않습니다. 출처: NVIDIA의 GPU 성능 제한 요인 설명
애니메이션에서 8단·12단·16단을 차례로 선택해 보세요. 기본 조건은 다이당 24Gb, 외부 데이터폭 1,024bit, 핀당 9.2Gb/s, 스택 1개입니다. 용량은 24→36→48GB로 늘고 대역폭은 그대로인 것을 볼 수 있어요. 가상 데이터 32GB가 한 스택의 용량 안에 들어가는지도 함께 비교합니다. 이 데이터 묶음은 저장 공간 설명용이며 실제 AI 모델 실행 가능 여부를 판정하는 기능이 아닙니다.
‘비교 조건 바꾸기’에서는 다이 밀도와 데이터폭, 독립 스택 개수도 바꿔볼 수 있어요. 실제 제품 버튼이 아닌 독립 변수를 살펴보는 학습용 조합입니다. 흐르는 점은 가상의 데이터 묶음이며, 같은 인터페이스 조건에서는 단수를 바꿔도 바깥 통로의 점 송출 빈도를 늘리지 않습니다.
8. 54초로 복습하기
54초 · 직접 제작한 자막 애니메이션 · 음성 없음
오늘의 질문에 답하면 이렇습니다. 같은 칩을 더 쌓으면 용량은 단수에 비례해 늘어납니다. 대역폭은 데이터폭과 전송률, 실제 AI 성능은 작업 조건까지 확인해야 합니다.
처음부터 연결해 보고 싶다면 HBM 기초 편, 만드는 과정은 전공정·후공정 총정리와 연재 20편에서 이어 보세요.
자료 확인: 2026년 11월 19일. 그림 6장과 영상은 직접 제작한 교육용 모식도입니다. 실제 제품 사진·정확한 축척·실측 성능 그래프가 아니며, 공표 사례·계산 예·발표 당시 상태를 각 설명에 구분했습니다.
#HBM #HBM8단 #HBM12단 #HBM16단 #HBM3E #HBM4 #메모리용량 #메모리대역폭 #AI반도체 #반도체패키징 #TSV #반도체공부