모아의 기웃기웃 · HBM 더 알아보기
8단·12단·16단,
무엇이 달라질까?
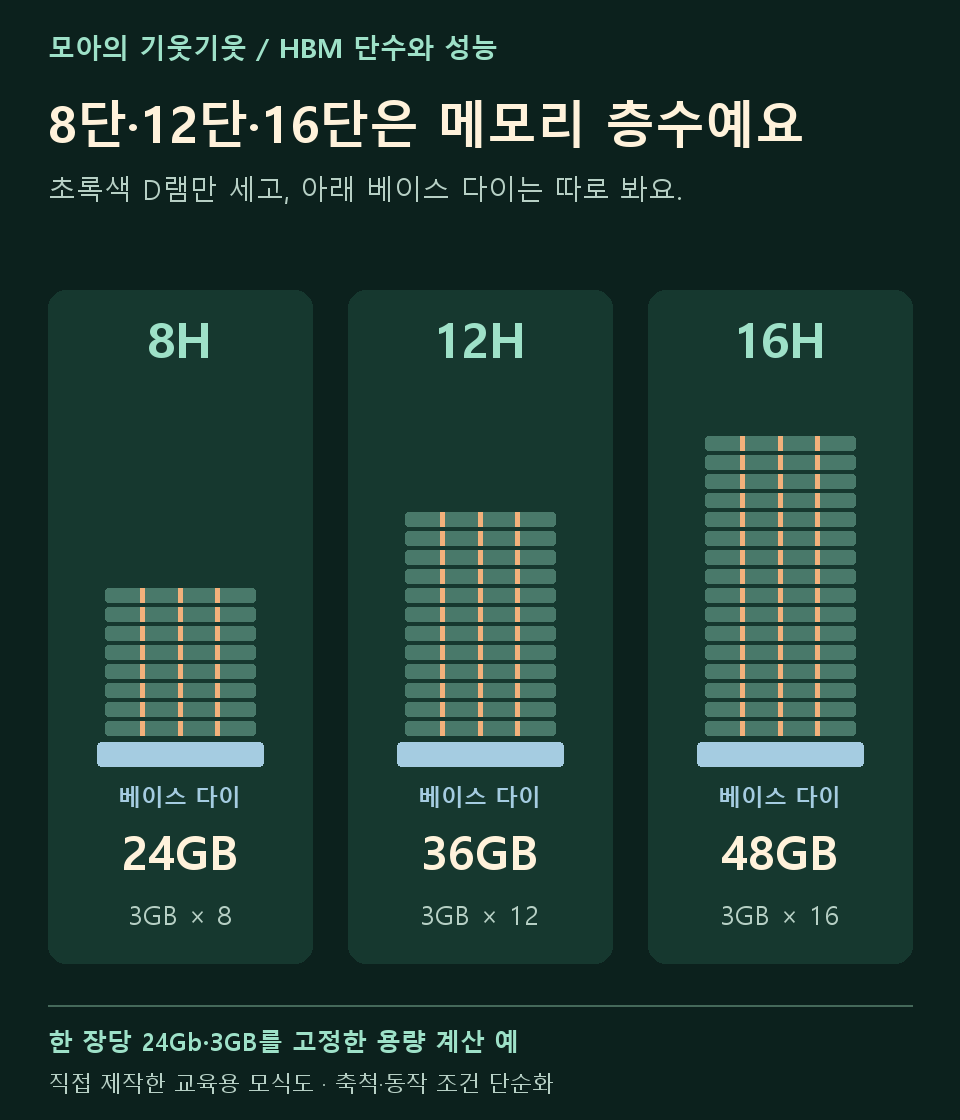
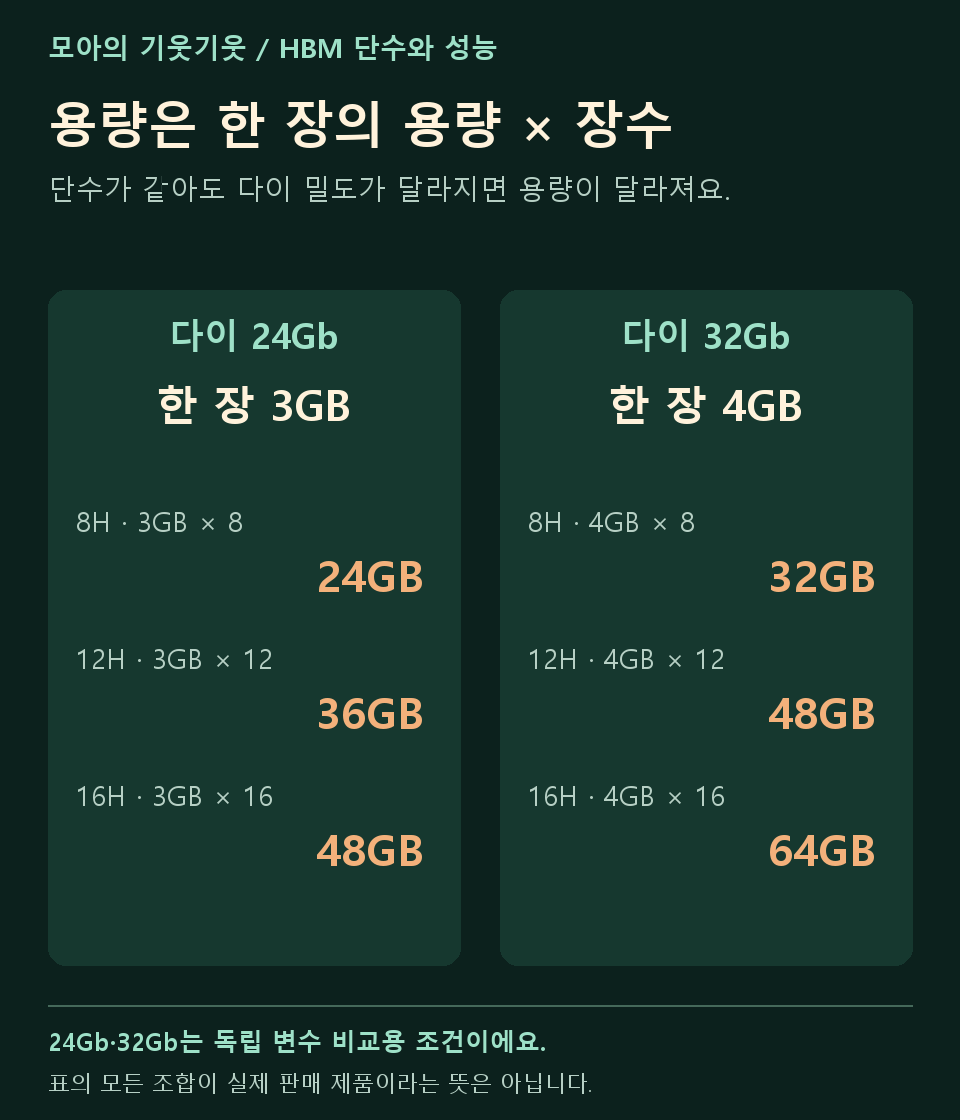
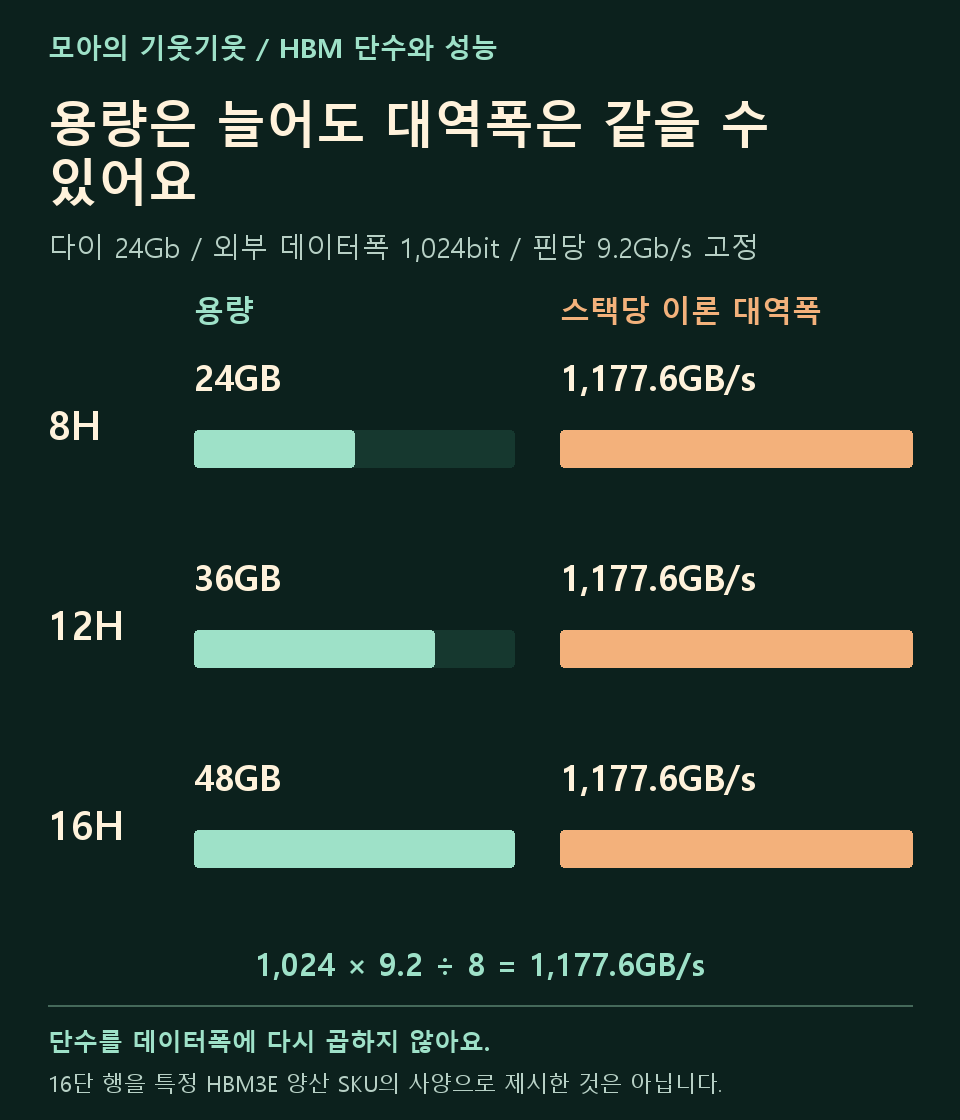
같은 칩을 더 쌓으면 저장할 공간이 늘어요. 스택 바깥의 데이터 통로와 전송률이 같다면 이론 대역폭은 그대로입니다. 먼저 단수만 바꿔 비교해 보세요.
HBM 적층 비교 실험실
다이 24Gb·3GB / 외부 데이터폭 1,024bit / 핀당 9.2Gb/s
D램 8장 + 별도 베이스 다이
선 1개는 외부 데이터 통로 128bit 묶음이에요. 점은 같은 속도로 이동하는 가상 데이터 묶음입니다. 단수만 바꾸면 외부 통로의 송출 빈도는 그대로예요. 층수 그림은 실제 패키지 높이·배선·신호 속도를 재현하지 않습니다.
저장 공간만 비교하는 예예요. 실제 AI 모델 실행 가능 여부나 메모리 배치·오프로딩 동작을 판정하지 않습니다.
| 단수 | 용량(GB) | 대역폭(GB/s) |
|---|
비교 조건 바꾸기
아래는 독립 변수 실험입니다. 특정 세대·실판매 SKU를 선택하는 기능이 아니에요. 핀당 전송률은 9.2Gb/s로 고정합니다.
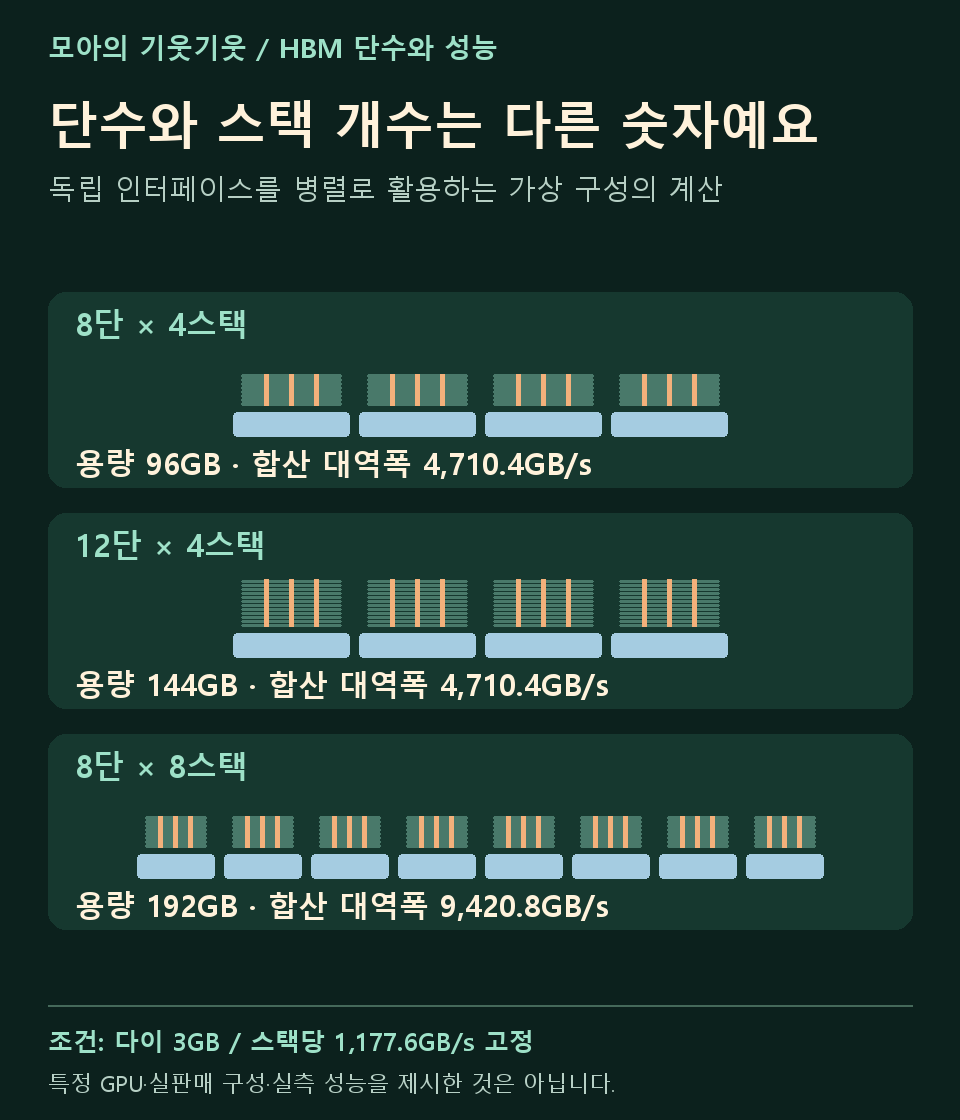
1스택 합계: 24GB · 합산 이론 대역폭 1,177.6GB/s
합산은 각 스택의 독립 통로를 병렬로 활용한다고 가정한 계산이에요. 실제 GPU 성능이나 토큰 처리 속도의 예측값이 아닙니다.
계산 예와 실제 제품 수치 읽기
위의 1,177.6GB/s는 1,024bit × 9.2Gb/s ÷ 8의 계산값이에요. Micron이 공표한 HBM3E의 ‘1.2TB/s 초과’는 해당 제품의 사양이며, 앞 계산을 반올림한 값이 아닙니다. 제조사·세대·데이터폭·전송률을 함께 비교해 주세요.
왜 더 쌓고, 무엇이 어려워질까요?
AI 실행에는 가중치 외에 KV 캐시와 계산 중간 결과도 저장해야 해요. 용량이 늘면 GPU 가까이에 둘 수 있는 데이터의 여지가 커집니다. 더 많은 칩을 정해진 높이 안에 넣으려면 박형화·정렬·접합·휨·방열 관리도 함께 풀어야 합니다.
단수만으로 답할 수 없는 것들
같은 12단, 다른 대역폭
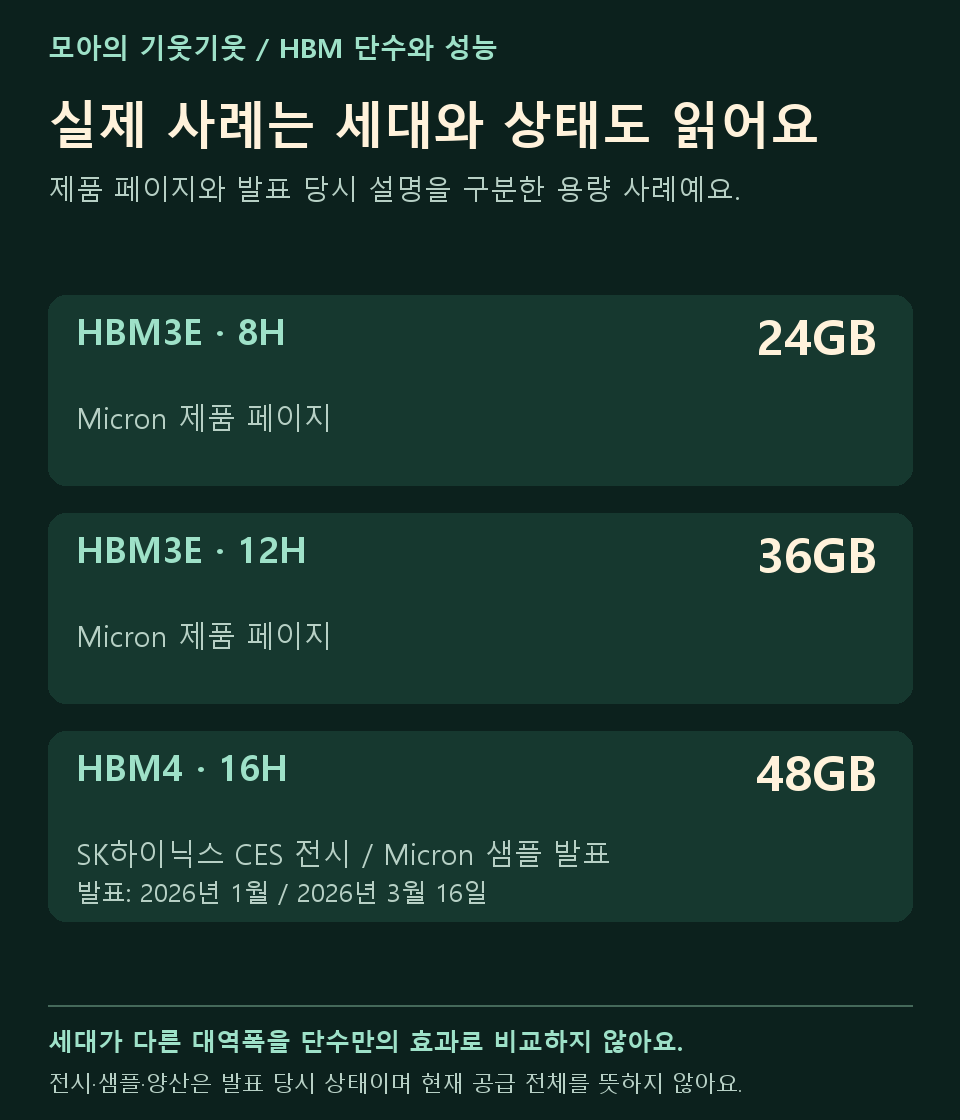
Micron은 2026년 3월 발표에서 같은 36GB·12H 구성의 HBM3E와 비교해 HBM4 대역폭이 2.3배라고 설명했어요. 단수와 세대 효과를 구분하는 사례입니다.
더 많은 층, 같은 전체 두께
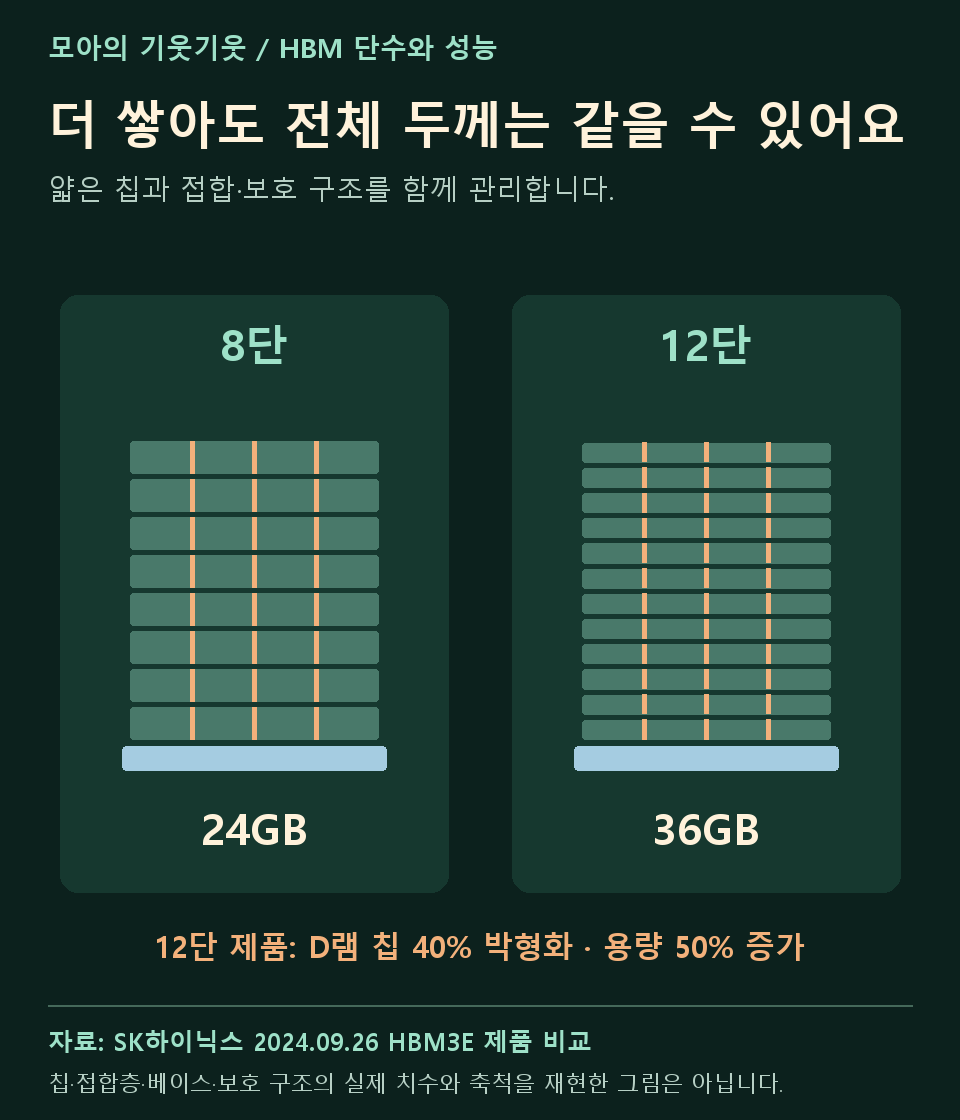
SK하이닉스는 2024년 12단 HBM3E에서 이전 8단 제품과 전체 두께를 유지하며 D램 칩을 40% 얇게 만들었다고 밝혔어요. 해당 제품 비교 수치입니다.
그림 6장으로 이어 보기
54초로 복습하기
직접 제작한 자막 애니메이션 · 음성 없음 · 실제 제품 영상·성능 측정 아님
수치와 구조의 출처
- Micron HBM 구조 · 적층 DRAM과 베이스 다이
- Micron HBM3E · 8H24GB·12H36GB와 대역폭 공표
- 삼성 HBM3E · 기본 계산에 사용한 1,024bit·9.2Gb/s
- SK하이닉스 CES 2026 · HBM4 16단48GB 전시 발표
- Micron HBM4 · 2,048bit 인터페이스
- NVIDIA GPU 성능 배경 가이드 · 실제 작업의 병목